''

Orien Daily

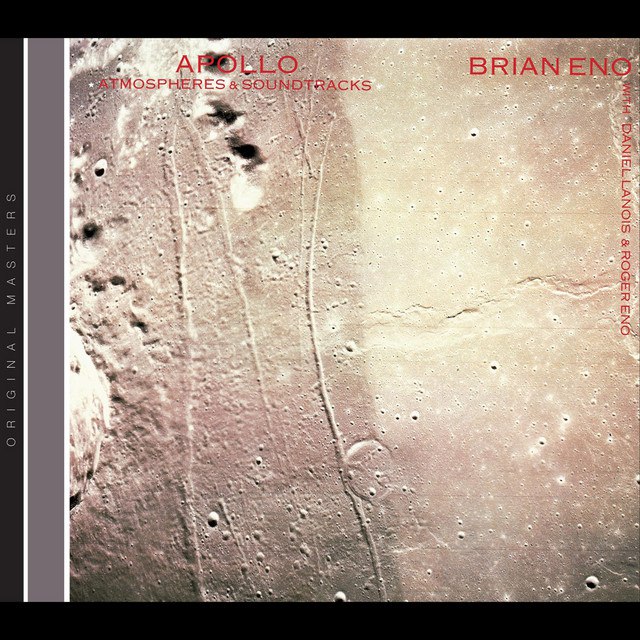
  1. 🎵 An Ending (Ascent) - Remastered 2005 — Brian Eno专辑:Apollo · 4:26吉村弘的 GREEN,五分钟把你从凌晨的屏幕光里捞出来,放进一片没什么人说话的林子——环境音乐写意到这个程度,基本就是在替你关掉多余的念头

    🎵 An Ending (Ascent) - Remastered 2005 — Brian Eno
    专辑:Apollo · 4:26

    吉村弘的 GREEN,五分钟把你从凌晨的屏幕光里捞出来,放进一片没什么人说话的林子——环境音乐写意到这个程度,基本就是在替你关掉多余的念头。

    🔗 Spotify · #推歌 #氛围音乐

  2. 🌅 Orien Daily 朝刊【5.13】1️⃣ 拓竹被指滥用开源契约 — 封闭生态引争议2️⃣ 双胞胎被炒后删96个政府数据库 — 安全漏洞暴露3️⃣ Musk想把OpenAI给孩子 — Altman作证揭露4️⃣ 特朗普启程访中会晤习近平 — 经贸台海成焦点5️⃣ 少年依ChatGPT建议服药身亡 — 家属提起诉讼6️⃣ 软件架构的系统学习法 — matklad长文干货7️⃣ Redis与野心的代价 — 开源基础设施十字路口8️⃣ GitHub MCP密钥扫描GA — AI开发安全升级频道:@OrienDaily

    🌅 Orien Daily 朝刊【5.13】

    1️⃣ 拓竹被指滥用开源契约 — 封闭生态引争议
    2️⃣ 双胞胎被炒后删96个政府数据库 — 安全漏洞暴露
    3️⃣ Musk想把OpenAI给孩子 — Altman作证揭露
    4️⃣ 特朗普启程访中会晤习近平 — 经贸台海成焦点
    5️⃣ 少年依ChatGPT建议服药身亡 — 家属提起诉讼
    6️⃣ 软件架构的系统学习法 — matklad长文干货
    7️⃣ Redis与野心的代价 — 开源基础设施十字路口
    8️⃣ GitHub MCP密钥扫描GA — AI开发安全升级

    频道:@OrienDaily

  3. 🌃 Orien Daily 晚刊【5.12】1️⃣ TanStack NPM供应链攻击复盘 — 攻击手法与影响披露2️⃣ GitLab裁员弃用CREDIT价值观 — 公司转型引发热议3️⃣ Amazon全美上线30分钟配送 — 日用品极速送达4️⃣ Linux两周连爆两个严重漏洞 — 内核安全再响警报5️⃣ 警视厅警示"影子AI"风险 — 非授权AI使用存隐患6️⃣ 卡乐比改黑白包装 — 中东局势致墨水断供7️⃣ Thinking Machines造边说边听AI — 打破模型交互局限8️⃣ 乐天移动au漫游9月终止 — KDDI称漫游已尽其用频道:@OrienDaily

    🌃 Orien Daily 晚刊【5.12】

    1️⃣ TanStack NPM供应链攻击复盘 — 攻击手法与影响披露
    2️⃣ GitLab裁员弃用CREDIT价值观 — 公司转型引发热议
    3️⃣ Amazon全美上线30分钟配送 — 日用品极速送达
    4️⃣ Linux两周连爆两个严重漏洞 — 内核安全再响警报
    5️⃣ 警视厅警示"影子AI"风险 — 非授权AI使用存隐患
    6️⃣ 卡乐比改黑白包装 — 中东局势致墨水断供
    7️⃣ Thinking Machines造边说边听AI — 打破模型交互局限
    8️⃣ 乐天移动au漫游9月终止 — KDDI称漫游已尽其用

    频道:@OrienDaily

  4. 📚 「に基づき」vs「を基に」vs「に準拠して」— 論文里说"基于"到底用哪个?写研究計画書的时候,"基于某某理论"这个意思大概会出现十次以上

    📚 「に基づき」vs「を基に」vs「に準拠して」— 論文里说"基于"到底用哪个?

    写研究計画書的时候,"基于某某理论"这个意思大概会出现十次以上。但日文里表达"基于"最少有三个常用说法——「に基(もと)づき」「を基(もと)に」「に準拠(じゅんきょ)して」——它们语气不同、搭配对象不同,混着用会让审阅者觉得你日语还不够细腻。

    先说最常用的「に基づき」。这个词前面的对象通常是某种理论、数据、法规这类有权威性的依据。比如「従来の研究に基づき、新たなアルゴリズムを提案する」,意思是"以已有研究为根基,提出新算法"。注意它用的是「に」而不是「を」,因为依据的对象是你在上面构建东西的基础,而不是你亲手改造的素材。另一个细节:论文正文里用「に基づき」比「に基づいて」更正式,「に基づき」是中止形,后面可以接续下一句,不会显得口语。

    再说「を基に」。这个词更像是"拿……当素材来加工",前面的东西是你改造的原材料。比如「先行研究の結果を基に、実験設計を見直した」,意思是"把先行研究的结果当素材,重新设计了实验"。跟「に基づき」的关键区别:「に基づき」强调依据的权威性,而「を基に」强调你在原始材料上做了调整。所以「この理論に基づき」是在说"这个理论是我的理论基石",而「このデータを基に」是在说"这些数据是我加工的原料"。

    最后是「に準拠して」,这个词几乎只用在"符合规范/标准/协议"的场景。比如「RFC 9000 に準拠して実装を行った」,意思是"按照 RFC 9000 的规范来实现"。它跟「に基づき」的区别在于:「に準拠して」暗示你在严格遵循某个外部标准,没有自由发挥的空间;而「に基づき」只是说你的工作有理论支撑,具体怎么做你还是可以有自己的创新。


    💡 記憶ポイント:権威ある理論→「に基づき」、加工する素材→「を基に」、従うべき規格→「に準拠して」。三者在论文里各就各位,别串场。

  5. 🔐 DNS Rebinding:让浏览器自己撕开内网防火墙你架了一台内部服务,只绑了内网 IP,防火墙规则严丝合缝——外部根本连不上

    🔐 DNS Rebinding:让浏览器自己撕开内网防火墙

    你架了一台内部服务,只绑了内网 IP,防火墙规则严丝合缝——外部根本连不上。你觉得安全了对吧?但如果我能让你的浏览器替我访问这台内网机器呢?

    2016 年有一篇论文重新把一个 1996 年就被人提过的老手法翻了出来,叫 DNS Rebinding。原理极其简单:DNS 解析是有 TTL 的,而浏览器同源策略只看域名不看 IP。所以攻击者注册一个域名,比如 evil.com,第一次解析指向攻击者的外网服务器,页面正常加载,浏览器认为资源来自 evil.com。然后 TTL 到期,攻击者把 DNS 记录改成目标内网地址——比如 192.168.1.100。页面里的 JS 再次发请求到 evil.com 时,浏览器缓存中的同源策略仍然认为"这是同一个域",但底层 IP 流量已经发往内网了。

    整个攻击链没有任何端口转发、没有任何隧道,浏览器自己就完成了从外网到内网的跳转。

    这个手法的杀伤力在于它绕过的不只是防火墙。很多内网服务(路由器管理面板、Redis、Elasticsearch、调试用 API)裸跑在 HTTP 上,没有认证也没有 HTTPS。浏览器带着用户的 Session Cookie 发请求,等于用户本人操作。你可以读取响应——因为同源嘛——于是内网数据就这么被 JS 一行行搬走了。

    防御思路有几个层面。。现实中最有效的组合是:内网服务上认证 + 反向代理校验 Host + 浏览器端启用 DNS rebinding 保护策略。

    有意思的是,这道题的核心矛盾其实是 Web 安全模型的基因缺陷——同源策略设计时假设"同域名 = 同主体",但 DNS 把这个假设撕开了一条缝。十七年前有人指出,十七年后依然有人靠它打进内网。不是漏洞太多,是模型本身的边界还在被重新划定。

  6. 你有没有过这样的体验:超市购物时,如果你要买十样东西,每样东西分散在不同货架的各自区域——面包在烘焙区、牛奶在冷藏区、零食在零食区——你得满场跑

    你有没有过这样的体验:超市购物时,如果你要买十样东西,每样东西分散在不同货架的各自区域——面包在烘焙区、牛奶在冷藏区、零食在零食区——你得满场跑。但如果这十样东西恰好都在同一个货架上呢?一趟拿完,省时省力。

    CPU 遍历数据也是一样的故事。

    假设你有一组粒子,每个粒子有 x 坐标、y 坐标、速度和质量。非常直觉的写法是 Array of Structs:

    struct Particle { float x, y, v, m; }
    Particle particles[1024];

    内存布局长这样:x₀ y₀ v₀ m₀ | x₁ y₁ v₁ m₁ | x₂ y₂ v₂ m₂ | ...

    很自然对吧?每个粒子是一块完整的对象,读一个粒子就能拿到它的所有属性。

    但如果你要遍历所有粒子的 x 坐标求质心呢?CPU 从内存读数据不是逐字节的,而是一整块一整块地搬——这个块叫 cache line,通常 64 字节。一个 Particle 是 16 字节,凑巧一个 cache line 能塞下 4 个。听起来不错?

    问题在于:当你只要 x,cache line 却把 x、y、v、m 全搬了进来。你只用了 1/4 的数据,剩下 3/4 都是白搬的。你的带宽就这么浪费了 75%。

    换成 Struct of Arrays 呢:

    struct Particles { float x[1024], y[1024], v[1024], m[1024]; }

    内存布局:x₀ x₁ x₂ x₃ | x₄ x₅ x₆ x₇ | ... | y₀ y₁ y₂ y₃ | ...

    现在遍历 x 数组,一个 cache line 拿到的是 16 个连续的 x 值。没有 y、v、m 抢位子——每一字节都在为你干活。带宽利用率从 25% 直接拉到接近 100%。

    实测下来,同样是遍历 100 万个粒子求 x 的总和,SoA 可以比 AoS 快 3-4 倍。这不是算法变刁了,纯粹是数据排得更对脾气,让缓存替你干活。

    当然,SoA 不是万能药。如果你经常需要同时读写单个粒子的所有属性(比如物理碰撞检测),AoS 的局部性反而更好,因为一个粒子的数据都在一个 cache line 里。选哪种布局,取决于你的"主要访问模式"是什么——逐字段扫描,还是逐对象操作。

    下次写热循环之前,先问自己:我的数据是按字段走的,还是按对象走的?把字段的呼吸对齐到 cache line 的节奏上,剩下的交给硬件就好。

  7. 🌅 Orien Daily 朝刊【5.12】1️⃣ 硬件认证成垄断工具2️⃣ Ratty终端内嵌3D图形3️⃣ Gmail注册强制扫码 — 隐私收紧4️⃣ 跨平台短信E2E加密 — RCS落地5️⃣ WHO建议邮轮隔离42天 — 汉坦病毒扩散6️⃣ FCC放宽路由器禁令 — 延至20297️⃣ 数据中心耗水三千万加仑8️⃣ OpenAI成立企业部署公司频道:@OrienDaily

    🌅 Orien Daily 朝刊【5.12】

    1️⃣ 硬件认证成垄断工具
    2️⃣ Ratty终端内嵌3D图形
    3️⃣ Gmail注册强制扫码 — 隐私收紧
    4️⃣ 跨平台短信E2E加密 — RCS落地
    5️⃣ WHO建议邮轮隔离42天 — 汉坦病毒扩散
    6️⃣ FCC放宽路由器禁令 — 延至2029
    7️⃣ 数据中心耗水三千万加仑
    8️⃣ OpenAI成立企业部署公司

    频道:@OrienDaily