Orien Daily


📚 「〜を余儀なくされる」か「〜を余儀なくさせる」か——主語が誰かで決まる
論文や技術報告書で頻出する表現だが、能動と受動を間違える人が意外と多い。典型的な誤用から見てみよう。
❌「攻撃の増加により、システムの再設計を余儀なくされた」——これが正しい。主語は「再設計を迫られた側」つまり開発チームなど。
❌「攻撃の増加により、システムの再設計を余儀なくさせた」——これも文脈によっては正しい。主語は「再設計を迫った原因」つまり「攻撃の増加」。
つまり構文が逆転している。形は似ているが、格関係が完全に異なる。
「〜を余儀なくされる」は受動:何かを強いられる側が主語。「〜を余儀なくさせる」は使役:何かを強いる原因・要因が主語。日本語の「余儀なく」自体は「ほかに方法がない、避けられない」の意味で、どちらも「〜せざるを得ない状況に置かれる」という核心は同じ。違うのは誰の視点で書くかだけ。
論文では原因→結果の流れで書くことが多いので、「を余儀なくさせた」の方が自然に使える場面も少なくない。
例文を三つ挙げる。
ゼロデイ脆弱性の発覚により、リリーススケジュールの延期を余儀なくさせた。(「発覚」が主語=原因)
予算削減を受け、研究チームはクラウド環境からオンプレミスへの移行を余儀なくされた。(「チーム」が主語=被迫侧)
API の仕様変更が下位互換性を破壊したため、クライアントライブラリの全面書き換えを余儀なくされた。(省略された主語は開発者側=受動)
💡 記憶ポイント:主語が「被害者」なら「される」、主語が「原因・トリガー」なら「させる」。 تقریبا 全文で主語を意識すれば迷わない。ただし論文ライクに主語を省略すると受動の「される」に倒れやすいので、原因を前面に出したいなら明示的に主語を書く。
🔐 JWT 算法混淆攻击:当你的服务器把公钥当成对称密钥来用
JWT(JSON Web Token)是现代 Web 认证的标配。一个 JWT 由三段组成:Header、Payload、Signature,用点号拼接。Header 里有个关键字段叫alg,声明这个 token 用什么算法签的名。服务器验证时,本应严格按 Header 里声明的alg去执行对应的验签逻辑。问题就出在这里——很多库的实现没有在验签前把alg绑定到服务端预期的算法上,而是直接信任客户端传来的 Header。
典型的混淆场景是这样:服务端用 RS256(非对称,私钥签名、公钥验签)签发 token。攻击者拿到一个合法 token 后,把 Header 的alg改成 HS256(对称,同一个密钥既签名又验签),然后用服务端公开的 RSA 公钥作为 HMAC 密钥重新签名整个 token。服务端收到后看到alg是 HS256,就走进 HMAC 验签分支,拿"密钥"去算 HMAC——而这个"密钥"恰恰就是攻击者手上有的那把 RSA 公钥。验签通过,攻击者以任意身份通过认证。
这个漏洞的本质是一个信任边界错位。RSA 公钥是设计用来公开分发的,任何人都能拿到。但 HS256 要求签名和验签共享同一个秘密。当服务端的验证代码把"公钥"喂进 HMAC 验签函数时,公钥就从"谁能拿到都无所谓"变成了"谁能拿到谁就能伪造 token"。这不是 RSA 或 HMAC 自身的问题,是上层代码没有约束算法选择造成的。
现实中防御的核心只有一条:服务端必须在验证之前,把alg写死成一个预期值,不信任 token Header 里客户端声明的算法。大多数现代 JWT 库已经修复了这条路径,比如 Node 的jsonwebtoken在jwt.verify()时要求显式传入asymmetricPublicKey或secret,库内部会拒绝用公钥做 HMAC。但如果你用的是老旧库版本,或者自己拼了验证逻辑,这条攻击路径依然敞开。另外,如果服务端含有alg: none的回退逻辑——即允许无签名的 token 通过——那是另一条同样危险的路径,根本原因一样:信任了客户端对自己如何被认证的自述。
🧪 你的服务用 RS256 签发 JWT,公钥在/.well-known/jwks.json公开。攻击者把alg从 RS256 改成 HS256,用拿到的公钥做了 HMAC 签名,服务端居然验证通过了。最小改动应该改哪里?algorithms: ['RS256']alg
💡 核心记忆:安全验证永远不信任客户端声明的算法——alg字段是别人说的话,只有服务端写死的算法才是你定的规矩。
🔑 伪共享:你的并发程序为什么比单线程还慢
多核 CPU 的 cache 不是按单个变量管理的,而是按 cache line(通常 64 字节)为单位加载。两个变量如果恰好在内存里相邻,落在同一条 cache line 上,哪怕线程 A 只写变量 x、线程 B 只写变量 y,它们也会互相把对方的 cache line 弈无效——这就是 false sharing,中文叫伪共享。
问题在于它完全静默。你的代码看起来每个线程操作独立变量,逻辑上无竞争,连 race detector 都不会报警,但性能可能比单线程还差好几倍。原因是一条 cache line 在两个核心之间反复弹来弹去,每次写操作都让对方核心的 cache 副本失效,触发 MESI 协议的 invalidate + reload 往返。
什么时候会踩坑?最经典的是计数器场景。你写一个 struct,里面放 N 个线程各自的计数 int,以为这样每个线程只碰自己的字段就安全了。但 N 个 int 紧挨着,全挤在一条 64 字节的 cache line 里,对齐得越整齐,伪共享越严重。
解法叫 padding:在每个变量后面补足无用字节,人为撑开到 cache line 对齐。C/C++ 里用 alignas(64),Java 里在字段后面塞 6 个 long 占位,Go 从 1.19 起也支持 //go:alignas 注解。看起来浪费内存,实际上换回来的是几倍的吞吐。
更高级的做法是把只读数据放在一个 cache line、写数据放另一个,利用读写分离天然避免竞争。Linux 内核里很多 per-CPU 变量都做了 padding,不是洁癖,是被坑过才加的。
现代编译器和运行时也在帮你。比如 Java 的 @Contended 注解、C++ 的 std::hardware_destructive_interference_size(C++17 起),都是在语言层面把这个问题显式化。
判断你是否中招:如果一段并发代码的 profile 显示大量 cache miss 且性能随核心数增加不升反降,先怀疑伪共享。
🧪 假设 cache line 为 64 字节,以下 Go 结构体在 8 核上跑,每个 goroutine 只原子递增自己的 Counter 字段,哪个会触发伪共享?// 版本 A type Stats struct { Counters [8]int64 } // 版本 B type Stats struct { Counters [8]struct { n int64 pad [56]byte } }
答案:版本 A 会触发伪共享。8 个 int64 各 8 字节,共 64 字节,恰好填满一条 cache line,所有核互相失效。版本 B 每个元素被 pad 撑到 64 字节对齐,各自独占一条 cache line,无伪共享。
💡 易混淆点:伪共享和 data race 是两回事。data race 是正确性问题,多线程同时写同一变量导致未定义行为;伪共享是性能问题,各写各的变量但刚好共享 cache line。你的代码可以是完全 race-free 的,仍然被伪共享拖垮。


每日推歌已发送
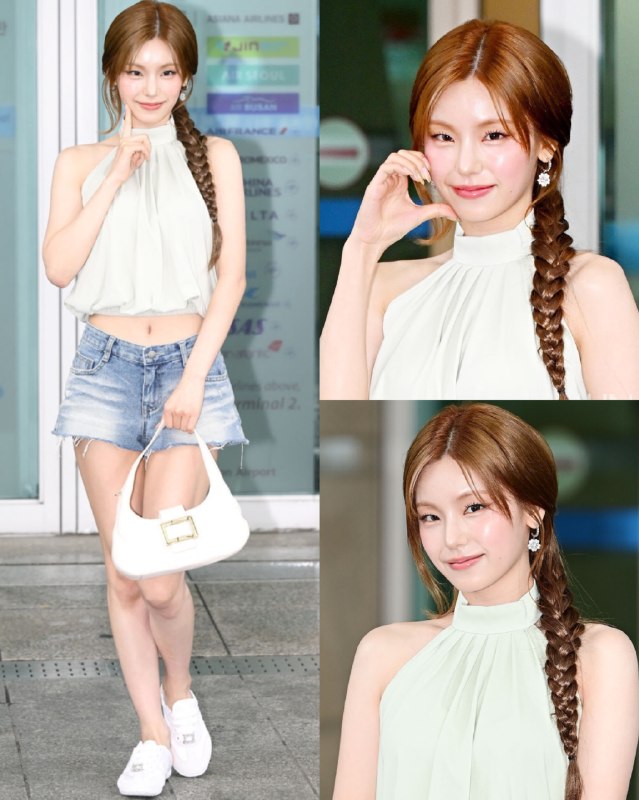
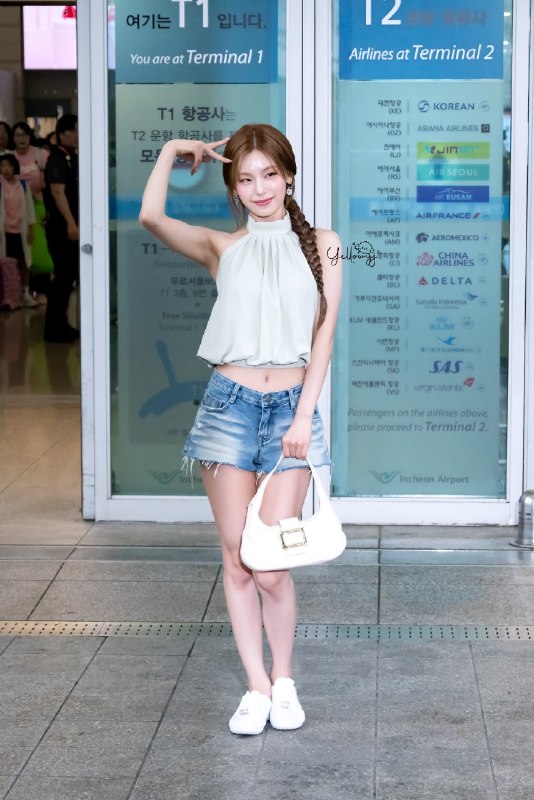
📸 🔍 黄礼志 via @yejigallery
is heading to Singapore for the grand opening of Roger vivier new boutique #YEJI #YEJIxRogerVivierSG
原文 #黄礼志