Orien Daily

📸 @Kendo_Jidai ×4
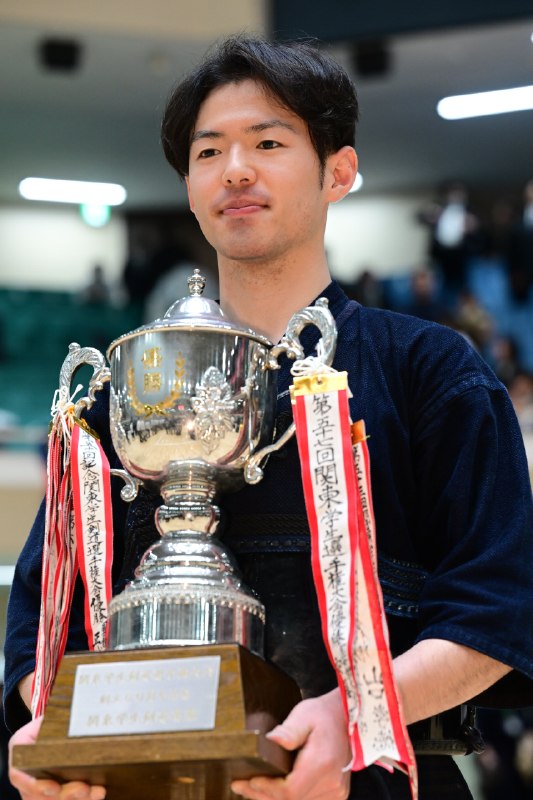
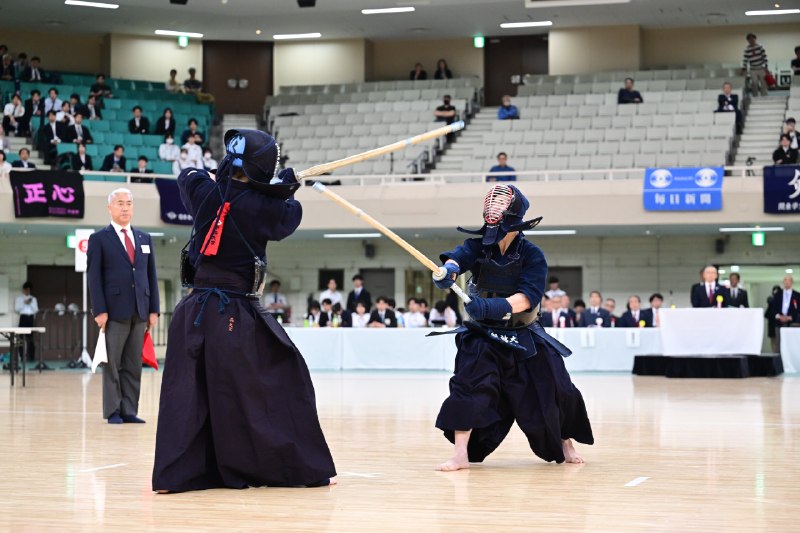
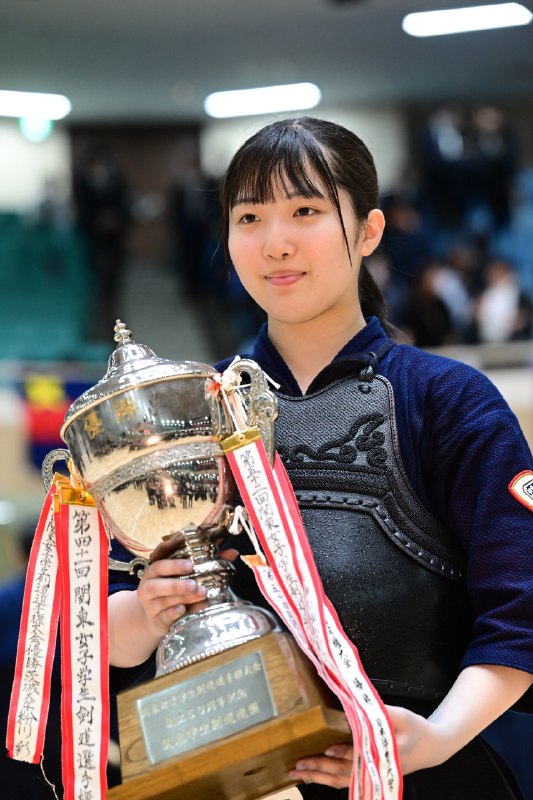
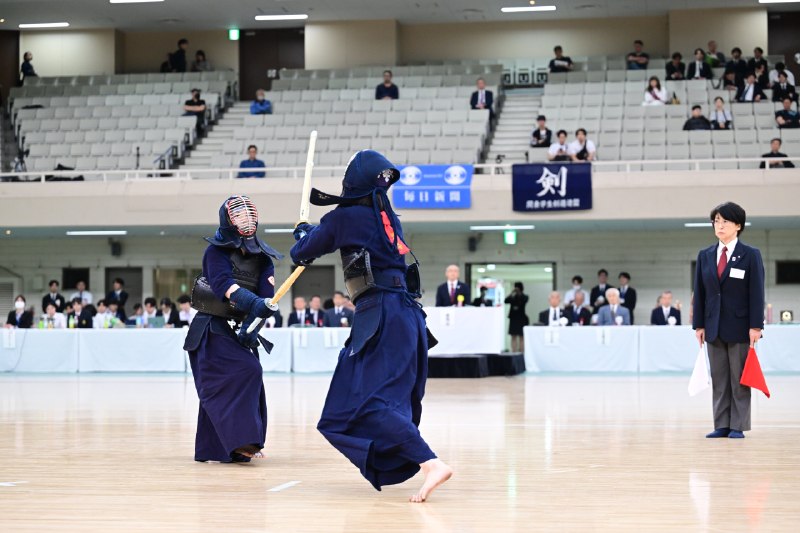
剣道時代8月号にて第72回関東学生剣道選手権大会、第58回関東女子学生剣道選手権大会のレポートを掲載しています。
男子優勝小栁宏成四段(筑波大4年・島原高出身)
女子優勝中司美羽三段(中央大1年・八代白百合学園高出身) #剣道
原文 #剣道
📸 @yeji_news ×2
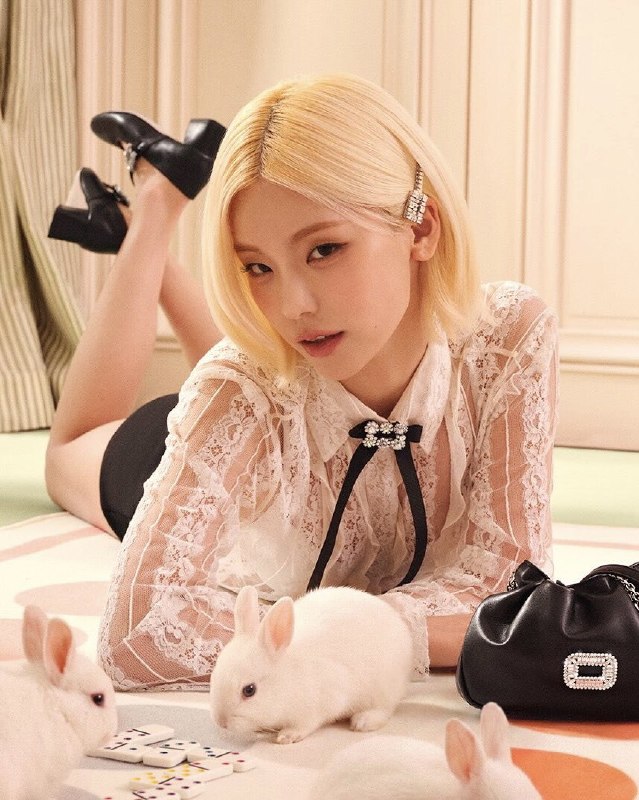
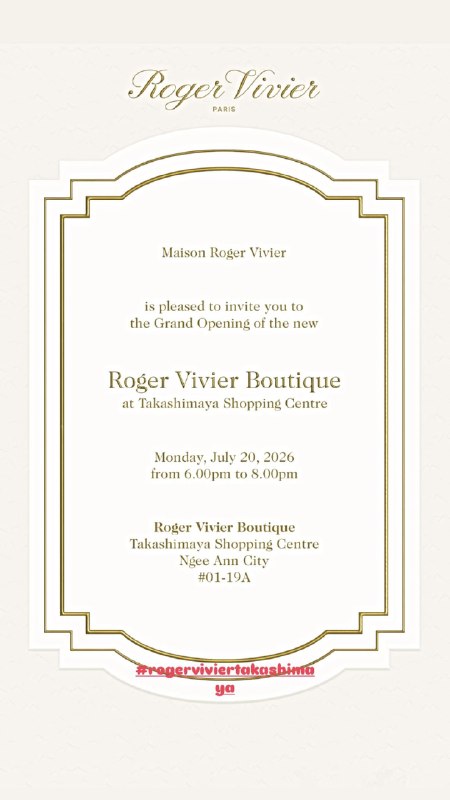
[ INFO ] The grand opening of Roger Vivier’s new boutique in Singapore will take place from 6–8PM on Monday, July 20 (local time).
NOTE: The event is closed to the public, but fans will have the opportunity to see during her photo call outside the venue. We hope many fans will come and show their ... #YEJI
原文 #黄礼志
📚 「にあたって」和「に際して」:都像“在……之际”,但正式度和动作边界不一样
很多人写技术邮件或研究计划时,会把「実験を始めるにあたって」和「実験を始めるに際して」当成完全同义。其实它们都能接在“重要动作、阶段切换、正式开始”前面,但语感不一样。「にあたって」更像“在做这件事之前,针对这个动作要先做说明或准备”,常见于研究启动、系统迁移、论文投稿、规则制定。「に際して」更正式、更书面,常见于通知、公告、契约、仪式性或组织性的场合,所以写制度说明、官方文档、学院通知时更稳。
边界在这里:如果只是日常连续动作,别硬用这两个。比如「ログを確認するにあたって」还说得过去,因为是在进入一个分析动作前提醒方法;但「昼ご飯を食べるに際して」这种就很假,像在给吃饭写行政通知。还有一点容易误用:它们前面通常接一次性、节点性的动作,不太接长期持续状态。所以「研究しているにあたって」不自然,应该改成「研究を進めるにあたって」或「研究にあたって」。
相近表达里,「前に」只是时间顺序,最普通;「際に」偏中性,像“……的时候”;「にあたって/に際して」则带有“这是个值得特别说明的关键节点”的味道。你想强调准备、方针、注意事项,用这两个;只是说先后关系,就别拔高。
例句可以直接套用。
「本システムを本番環境へ移行するにあたって、既存APIとの互換性を事前に検証する必要がある。」
在将本系统迁移到生产环境之前,有必要提前验证它与现有 API 的兼容性。
「論文を投稿するに際して、著者情報と利益相反の申告を再確認してください。」
在投稿论文之际,请再次确认作者信息和利益冲突声明。
「大規模データを共有するにあたって、匿名化の手順とアクセス権限の管理方針を明文化した。」
在共享大规模数据之前,我们把匿名化流程和访问权限管理方针写成了明确文档。
💡 記憶ポイント:要表达“进入一个重要动作或正式节点时,顺带说明准备、规则、注意事项”,用「にあたって」;要写得更像公告、通知、制度说明,用「に際して」。如果只是普通的“在……之前”,用 就够了;如果前面不是节点性动作,而是日常小事或持续状态,。
🔐 为什么一个“读网页截图”的功能,最后能偷到云服务器密钥:SSRF 与元数据服务
很多人第一次接触 SSRF(Server-Side Request Forgery,服务端请求伪造)时,会觉得它不过是“让服务器替我访问一个网址”。问题在于,服务器看到的世界,和普通用户看到的不一样。你的浏览器访问不了169.254.169.254,但部署在云上的应用服务器往往可以,因为那是云厂商给虚拟机暴露的元数据服务入口,用来发放临时凭证、实例信息、网络配置这些高价值内容。
这就是 SSRF 危险的地方:攻击者并不需要直接攻破服务器,只要找到一个“服务器代为发请求”的功能,比如导入图片 URL、抓取网页预览、下载 PDF、Webhook 回调测试、头像拉取、在线爬虫、Open Graph 预览,甚至某些 AI 插件里的“读取指定链接内容”,就可能把这个功能变成内网探针。表面上看,应用只是帮用户取了个 URL;实际上,它可能替攻击者访问了只有服务器自己才能访问的资产,包括 Redis、Kubernetes API、内部管理面板,或者云元数据服务。
现实攻击里,最经典的一步不是“读到首页”,而是“读到凭证”。例如在 AWS 旧式 IMDSv1 模式下,如果应用允许服务端无约束地请求 URL,攻击者就可能让服务器访问元数据接口,进一步读取 IAM Role 的临时 Access Key。拿到这类凭证后,攻击面会瞬间从一个 Web 漏洞扩展到对象存储、消息队列、数据库快照,甚至整套云资源。很多人以为“SSRF 只是内网探测”,这就太天真了,它真正值钱的地方是身份窃取和横向移动。
为什么这种问题会反复发生?因为业务开发常把“给一个 URL,我去抓内容”当成普通功能,却忽略了“请求是从谁的网络身份发出去的”。一旦请求发生在服务端,攻击者得到的就不是一个 HTTP 客户端,而是应用所在环境的网络位置、信任关系和权限边界。说白了,漏洞不在“URL 解析”本身,而在“把服务器变成了代理人,却没给它设边界”。
防护不能只靠一个“黑名单禁止 127.0.0.1”,那是典型补丁式思维。真正有效的是把出站请求当成高风险能力来设计:先做 allowlist,只允许访问业务确实需要的域名和协议;拒绝裸 IP、内网地址段、link-local 地址、非 HTTP/HTTPS 协议;解析域名后还要校验最终解析结果,防止 DNS Rebinding;禁用自动跟随重定向,或者每跳都重新做目标校验;把抓取服务放进单独的低权限沙箱里,和主业务隔离;云上要强制使用更安全的元数据访问模式,比如 AWS IMDSv2,并限制工作负载不必要的 IAM 权限。别幻想“这个接口只有内部人会用”,攻击者最喜欢的就是这种自我安慰。
🧪 题目:某后台有一个“抓取远程图片生成缩略图”的功能,开发只做了两件事:一是限制协议必须为http或https,二是屏蔽了127.0.0.1和localhost。这个防护为什么仍然可能被 SSRF 绕过?
💡 核心记忆:SSRF 的本质不是“多发了一个请求”,而是“让攻击者借用了服务器自己的网络位置和身份”。
📸 @habitosho
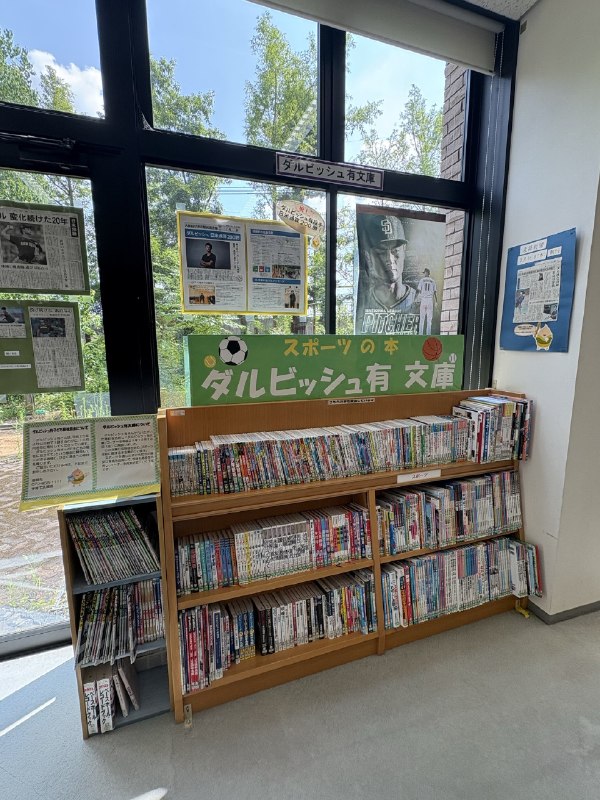
📚ダルビッシュ有 文庫📚中央図書館には今年入ったばかりの新しい本も含めて、約900冊の蔵書があります(2026年7月現在)。⚾️皆さん是非お気軽にお立ち寄りください
最近 子ども福祉基金にて購入した図書のリストはこちら↓
https://www.lics-saas.nexs-service.jp/habikino/shisetsu/pdf/dallist2026.pdf #ダルビッシュ有
原文 #MLB日本選手
🔑 为什么 Linux 里一切皆文件,socket 却又不完全是文件?
很多人第一次学 Unix 设计时会听到一句很顺耳的话:一切皆文件。它好记,也基本正确,因为普通文件、目录、管道、终端设备,都会被统一成“文件描述符”来读写,程序只要拿到一个整数句柄,就能用 read、write、close 这套接口处理。这种设计厉害的地方,不是“万物真的是同一种东西”,而是它先把用户态接口统一了,让工具可以自由组合,shell 重定向、管道、日志落盘这些能力都因此变得自然。
但 socket 正好能暴露这句话的边界。socket 确实也能得到文件描述符,你也能对它 read/write,甚至能塞进 select、poll、epoll 里统一等待;可它又不是真的普通文件,因为它没有稳定的“文件位置”,不能像磁盘文件那样随便 lseek,也不保证你这次 write 的边界、对端何时收到、网络何时断开。文件更像静态存储对象,socket 更像活着的通信端点。内核把它们塞进同一套抽象里,是为了减少接口数量,不是为了抹掉语义差异。
这就是 Unix 设计里很值得学的一点:先统一共性,再保留差异。好的抽象不是硬说“它们完全一样”,而是让 80% 的操作长得一样,剩下 20% 用更专门的系统调用补上,比如 socket 需要 connect、accept、sendmsg、recvmsg,普通文件则更关心 open、lseek、fsync。这样做的好处很现实:用户态程序先享受统一接口带来的简单,再在确实需要时承认底层对象不同。抽象如果过头,后面就会充满奇怪特判;抽象如果太弱,用户又得背一堆彼此割裂的 API。
所以,“一切皆文件”最好理解成“很多内核对象都被放进了文件描述符这层统一入口”,而不是“它们在行为上完全等价”。你一旦把这两件事混为一谈,后面写网络程序时就会踩坑:以为 socket 像文件一样可重复读到 EOF 才结束,或者以为一次 write 就等于对端一次完整接收。那不是代码问题,是抽象边界没看清。
🧪 如果一个 TCP socket 也有文件描述符,为什么程序通常不能像处理普通文件那样对它做有意义的 lseek 偏移操作?答案:
💡 易混淆点:“能用文件描述符操作”不等于“行为和普通文件完全一样”;统一的是接口入口,不是底层语义。
📸 @shinji_marosan ×3
皆様おはようございます😊
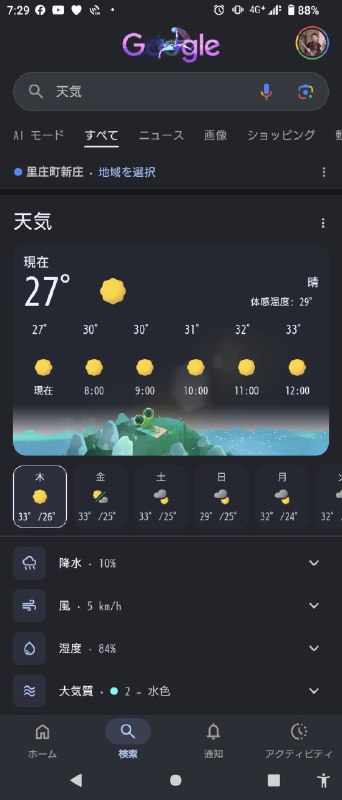
朝から猛烈な暑さ🥵
今日は会社出社で夜イベント🍺
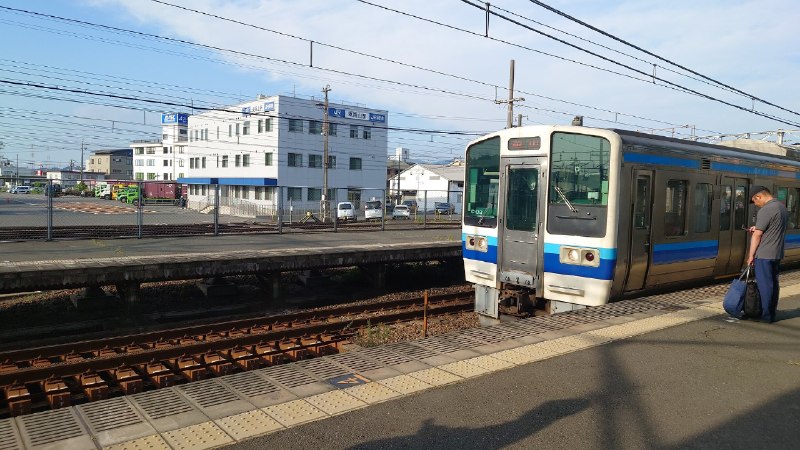
早く家を出て、座席数が多い
213系電車に乗る
この後の だと倉敷まで立ってないとダメなことが多いので😮💨
で、昨日は学区の青少年育成協議会があり出席のため 稽古はなしでした
昇段審査が近いのに😢 #urara #剣道
原文 #剣道