''

Orien Daily

  1. 🌃 Orien Daily 晚刊【6.6】1️⃣ S&P拒SpaceX—盈利卡门2️⃣ Mouseless—键盘控3️⃣ 英国支付换商—Adyen接手4️⃣ 音箱黑电脑—隔空感染5️⃣ 小核堆临界—美国首测6️⃣ Meta AI漏洞—账号被劫7️⃣ 3B多智能体—小模型实验8️⃣ 九州强降雨—警惕灾害频道:@OrienDaily

    🌃 Orien Daily 晚刊【6.6】
    1️⃣ S&P拒SpaceX—盈利卡门
    2️⃣ Mouseless—键盘控
    3️⃣ 英国支付换商—Adyen接手
    4️⃣ 音箱黑电脑—隔空感染
    5️⃣ 小核堆临界—美国首测
    6️⃣ Meta AI漏洞—账号被劫
    7️⃣ 3B多智能体—小模型实验
    8️⃣ 九州强降雨—警惕灾害
    频道:@OrienDaily

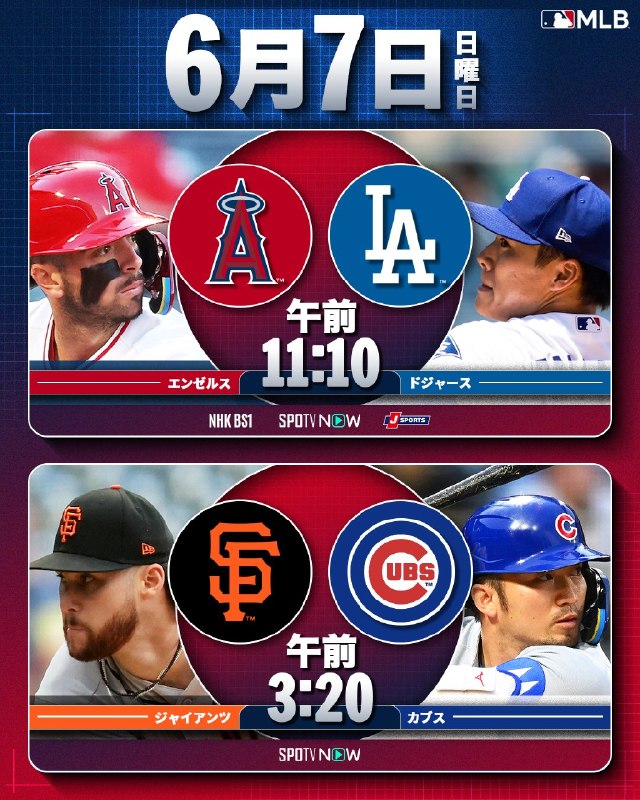
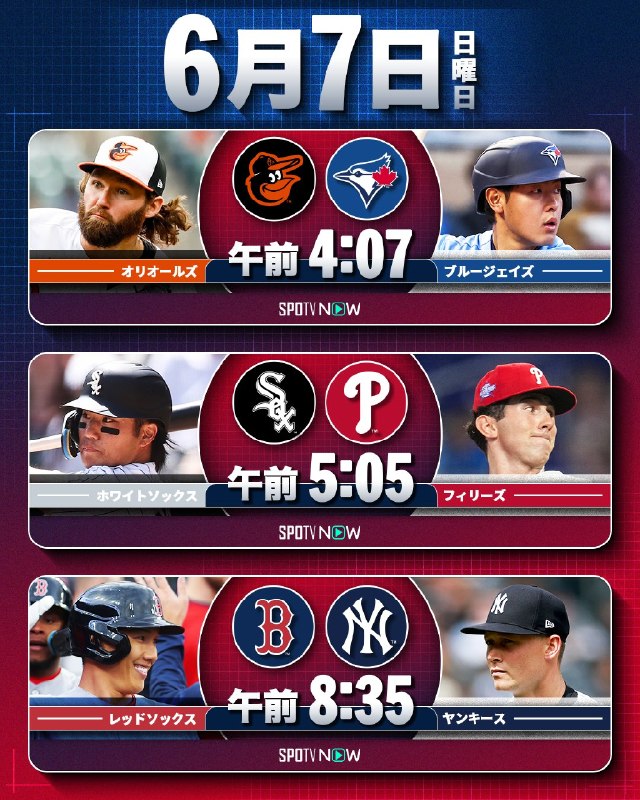
  2. 📸 @MLBJapan ×2/明日の注目ゲームはこちら🔥\🌴 明日は がマウンドへ!👀⚾️ 日本人野手たちの活躍にも期待!熱い声援をよろしくお願いします!▶️ NHK、J SPORTS、SPOTVNOWで生中継!お楽しみに! #山本由伸原文 #MLB日本選手

    📸 @MLBJapan ×2
    /
    明日の注目ゲームはこちら🔥
    \

    🌴 明日は がマウンドへ!👀
    ⚾️ 日本人野手たちの活躍にも期待!

    熱い声援をよろしくお願いします!

    ▶️ NHK、J SPORTS、SPOTVNOWで生中継!お楽しみに! #山本由伸
    原文 #MLB日本選手

  3. 📚「〜に照らして」:不是“按照”,而是拿标准来照一照在学术报告或技术讨论里,很多判断不能只说「いいと思います」「問題があります」

    📚「〜に照らして」:不是“按照”,而是拿标准来照一照

    在学术报告或技术讨论里,很多判断不能只说「いいと思います」「問題があります」。日语更喜欢把判断挂到一个清楚的标准上,比如法律、实验结果、仕様、安全基準、先行研究。这时可以用「〜に照らして」。

    「照らす」原本是“照亮”。所以「Aに照らしてBを判断する」的感觉是:把 B 放到 A 这束光下面看。比如「この実装は、セキュリティ基準に照らして不十分である。」意思不是随便说“这个实现不好”,而是“按照安全标准来看,这个实现不够”。

    它比「〜によると」更适合表达自己的判断。「〜によると」偏向“消息来源”,比如「資料によると、脆弱性が確認された」。但「〜に照らして」后面通常接评价、判断、再検討,比如「実験結果に照らして、仮説を修正する必要がある」。

    技术场景里可以这样说:「既存研究に照らして、この手法の新規性は限定的である。」这句话很硬,但有用。它没有情绪,只是在说:拿已有研究当标准来看,新意有限。

    💡 記憶ポイント:「〜に照らして」后面接的不是单纯事实,而是“基于某个标准做出的判断”。看到「基準」「規則」「結果」「先行研究」「仕様」这类词,它就很自然。

  4. Passkey 为什么比密码更难被钓鱼很多账号被盗,不是因为密码太短,而是因为用户把密码交给了假网站

    Passkey 为什么比密码更难被钓鱼

    很多账号被盗,不是因为密码太短,而是因为用户把密码交给了假网站。攻击者做一个长得像登录页的页面,用户输入密码和验证码,攻击者立刻拿去真网站登录。传统密码的问题在这里很蠢:它只是一段“谁拿到谁就能用”的字符串。

    Passkey 的思路不一样。它不把秘密交给网站,而是在你的设备里保存一把私钥,网站只保存对应的公钥。登录时,网站发来一个挑战,设备用私钥签名,网站用公钥验证。关键点是,这个签名会绑定网站域名。你在 fake-example.com 上点登录,设备不会给 example.com 的身份凭证签名。

    这就是 WebAuthn/FIDO2 的核心价值:它不是让用户“更小心”,而是把“用户会被骗”这个现实写进设计里。好安全设计不该指望人类每次都看清 URL,人类会累,会急,会犯错。系统应该让错误没法变成灾难。

    思考题:如果攻击者控制了一个假登录页,并实时转发用户操作到真网站,Passkey 为什么仍然比短信验证码更难被中间人攻击?

    💡 核心记忆:密码是“共享秘密”,被看见就完了;Passkey 是“证明我有私钥”,私钥不离开设备,钓鱼页面很难偷走可复用的登录材料。

  5. 蓄水池抽样:只看一遍,也能公平地抽一个有些数据不是整整齐齐放在桌上的

    蓄水池抽样:只看一遍,也能公平地抽一个

    有些数据不是整整齐齐放在桌上的。比如一条日志流、一个不断刷新的用户列表、一个你根本不知道长度的文件。你不能先数完它有多少项,也不能把它全部塞进内存再慢慢挑。问题来了:如果只能从头到尾看一遍,怎么从里面随机选出一个,并且保证每个元素被选中的机会一样?

    蓄水池抽样的想法很硬。看到第 1 个元素时,先选它。看到第 2 个元素时,用 1/2 的概率替换掉当前选择。看到第 3 个元素时,用 1/3 的概率替换。看到第 n 个元素时,就用 1/n 的概率替换。最后留下来的那个,就是公平样本。

    这听起来像碰运气,但它不是玄学。第 1 个元素一开始被选中,之后要一路不被第 2、3、4……n 个元素替换掉,概率是 1 × 1/2 × 2/3 × 3/4 × ... × (n-1)/n,最后正好是 1/n。第 k 个元素被选中的概率是 1/k,之后不被替换的概率是 k/(k+1) × ... × (n-1)/n,乘起来也正好是 1/n。

    它的好处不是“看起来聪明”,而是现实里真的有用:数据很大、长度未知、只能流式读取时,它用 O(1) 内存解决了公平抽样。没有临时数组,没有回退逻辑,也不需要假装自己能掌控整条数据流。

    难点在这里: