''

Orien Daily

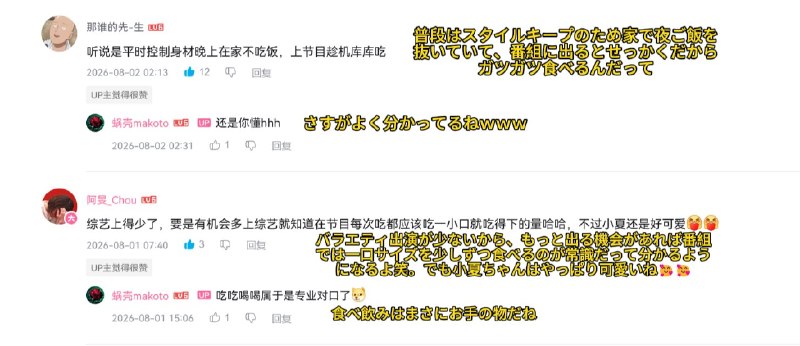
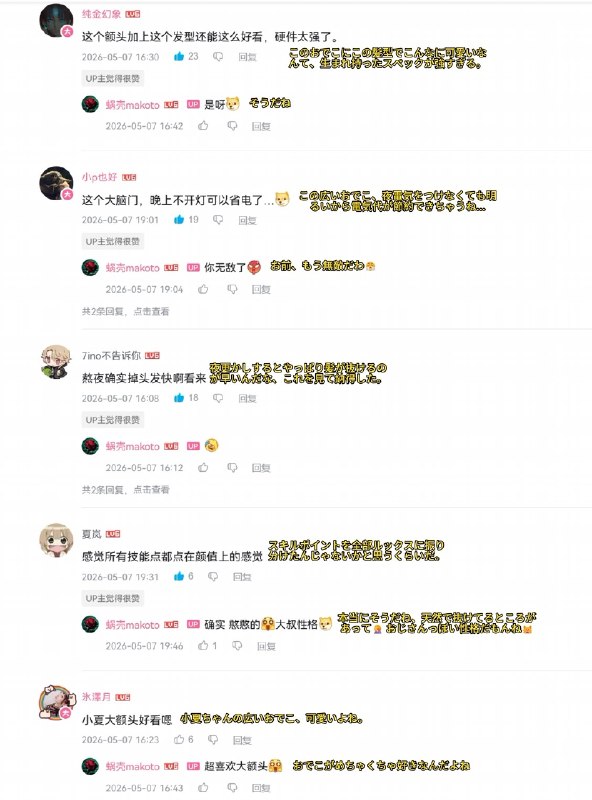
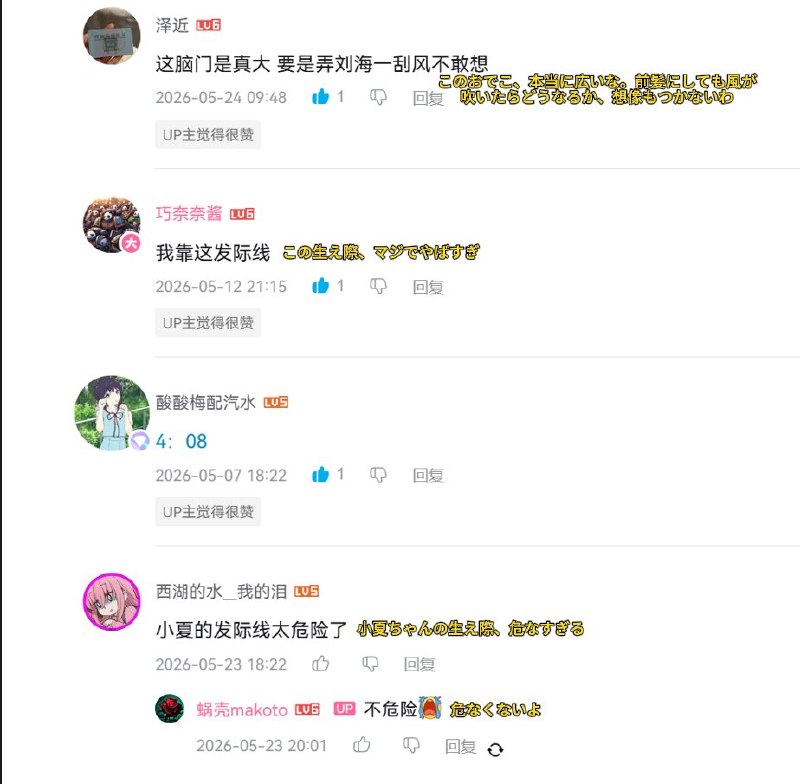
  1. 📸 @zzc1588532 ×4今回のコメントは加藤小夏さんの『The Day Room』第1期のコメント欄から抜粋したもので、面白くて笑えると思って持ってきました

    📸 @zzc1588532 ×4
    今回のコメントは加藤小夏さんの『The Day Room』第1期のコメント欄から抜粋したもので、面白くて笑えると思って持ってきました。
    (あくまで中国のネットユーザーによる冗談ですので、真に受けないでください!) #加藤小夏
    原文 #加藤小夏
  2. 🔑 Git reflog:误删分支后,Git 为什么还能救回来很多人以为,git reset --hard 之后,之前的提交就彻底消失了

    🔑 Git reflog:误删分支后,Git 为什么还能救回来

    很多人以为,git reset --hard 之后,之前的提交就彻底消失了。其实,Git 里的提交对象和分支名是两回事:提交本身通常不会被修改,分支只是一个指向某个提交的可移动指针。

    git reflog 记录的正是这些指针曾经指向过哪里。执行 git reflog,你可能会看到类似 reset: moving to HEAD~3 的记录,以及操作前的提交哈希。找到目标哈希后,就可以用 git reset --hard <commit-hash> 把分支指针移回去;如果只是担心再次操作失误,也可以先用 git branch rescue <commit-hash> 建一个临时分支。

    这个设计解决了一个实际问题:Git 允许你频繁重写本地分支历史,但不能因为一次误操作就立刻丢掉所有线索。只要旧提交还没有被 Git 的垃圾回收清理,reflog 就能提供恢复入口。

    不过,reflog 是本地记录,不会随 git push 上传到远程仓库。换一台机器,或者仓库长期没有访问导致过期记录被清理,就不一定还能找到它。发现误操作后,越早查看 reflog,恢复成功的机会越大。

    🧪 课后一题:你刚执行了 git reset --hard HEAD~3,想找回 reset 之前的分支位置,最可靠的做法是什么?
    git refloggit reset --hard <那个哈希>

    💡 易混淆点:git log 展示提交历史,而 git reflog 展示本地分支和 HEAD 指针的移动记录,后者不是远程共享日志。

  3. 🎵 Living Room — Grouper专辑:The Man Who Died in His Boat · 2:22像从昏暗室内飘出的残响,人声被朦胧的吉他雾气包住,安静却有一种持续下沉的牵引力;Grouper把盯鞋的失焦感写得更私密、更像记忆的回声

    🎵 Living Room — Grouper
    专辑:The Man Who Died in His Boat · 2:22

    像从昏暗室内飘出的残响,人声被朦胧的吉他雾气包住,安静却有一种持续下沉的牵引力;Grouper把盯鞋的失焦感写得更私密、更像记忆的回声。

    🔗 Spotify · #推歌 #盯鞋

  4. 📚 「~にあたって」和「~に際して」:都是“在……之际”,语气不一样「本番環境への移行にあたって、手順を確認する」和「本番環境への移行に際して、手順を確認する」都可以理解为“在切换到生产环境之际确认步骤”,但使用重点不同

    📚 「~にあたって」和「~に際して」:都是“在……之际”,语气不一样

    「本番環境への移行にあたって、手順を確認する」和「本番環境への移行に際して、手順を確認する」都可以理解为“在切换到生产环境之际确认步骤”,但使用重点不同。

    「~にあたって」强调为了迎接某件重要事情而进行准备、采取态度或制定方针,常用于项目启动、研究计划、入学、就任等场景。「~に際して」则更强调某个正式时点或特殊场合本身,常用于通知、规定、手续和注意事项,语气也更郑重。

    如果只是想明确表达“在……之前”,突出先后顺序,则用「~に先立って」更自然。

    研究計画を立てるにあたって、先行研究の調査範囲を明確にした。
    制定研究计划时,先明确了先行研究的调查范围。

    本番環境への移行に際して、アクセス権限を再確認してください。
    在切换到生产环境之际,请再次确认访问权限。

    学会で発表するに先立って、実験結果の再現性を検証した。
    在学会发表之前,验证了实验结果的可复现性。

    💡 記憶ポイント:
    「~にあたって」=;「~に際して」=;「~に先立って」=。普通的小事或日常动作不要使用这些郑重表达。

  5. 🔐 SSRF:你的服务器,可能成了攻击者的内网跳板SSRF(Server-Side Request Forgery,服务器端请求伪造)发生在应用允许用户提交 URL,并由服务器代为访问时

    🔐 SSRF:你的服务器,可能成了攻击者的内网跳板

    SSRF(Server-Side Request Forgery,服务器端请求伪造)发生在应用允许用户提交 URL,并由服务器代为访问时。攻击者不一定需要直接进入内网,只要诱导服务器请求 127.0.0.1、云平台元数据地址或内部管理接口,就可能读取敏感信息、调用高权限服务,甚至进一步控制主机。

    这类漏洞常见于图片抓取、网页预览、Webhook、PDF 生成和远程文件导入功能。问题的根源不是“请求了一个危险 URL”这么简单,而是服务器把用户输入当成了可信的网络目标,并且往往只检查初始域名,忽略了重定向、特殊 IP 表示方式和解析后的真实地址。

    防护时不要只维护一个“禁止访问的域名列表”,更可靠的做法是采用严格的目标白名单,只允许必要的协议、域名和端口;解析域名后检查 IPv4、IPv6 及 IPv4-mapped IPv6 地址,拒绝环回地址、私有地址、链路本地地址和云元数据地址;每次重定向后重新校验,并尽量关闭自动重定向。应用之外,还应通过出站防火墙限制服务器只能访问真正需要的网络,即使应用层校验被绕过,也不能直接触达内网。

    🧪 某图片抓取接口只允许 https://,并检查 URL 主机名不包含 localhost。攻击者提交一个外部 URL,服务端跟随 302 跳转到 http://169.254.169.254/,随后返回云主机临时凭证。最关键的漏洞点是什么,优先修哪两层?


    💡 核心记忆:凡是服务器替用户访问 URL,就必须同时验证“访问谁”和“能否连到那里”。

  6. 🔑 布隆过滤器为什么只能说“可能存在”当系统需要判断一个元素是否见过,直接保存完整集合可能很占内存

    🔑 布隆过滤器为什么只能说“可能存在”

    当系统需要判断一个元素是否见过,直接保存完整集合可能很占内存。布隆过滤器用一个位数组和多个哈希函数代替它:插入元素时,把多个哈希结果对应的位置设为 1;查询时,只要发现其中一个位置是 0,就能确定元素一定不存在。

    但如果所有位置都是 1,也不能断言元素一定存在,因为这些 1 可能是其他元素共同设置的。这就是布隆过滤器的核心取舍:用很少的内存换取极快的查询,但允许出现“误报存在”。增加位数组长度或调整哈希函数数量,可以降低误报率;然而,简单地把某个位置改回 0 又可能误伤其他元素,所以普通布隆过滤器不支持安全删除。需要删除能力时,通常改用计数布隆过滤器等变体。

    🧪 课后一题:如果布隆过滤器查询结果为“不存在”,这个结论是否绝对可靠?为什么?

    💡 易混淆点:布隆过滤器的“存在”是可能存在,而“不存在”才是确定不存在;同时,普通布隆过滤器不能直接删除元素。

  7. 🎵 mostly chimes — Adrianne Lenker专辑:instrumentals · 16:12听起来像零散钟声在寂静空间里缓慢荡开,泛音清亮却不喧闹,留白让每一次回响都变得很近

    🎵 mostly chimes — Adrianne Lenker
    专辑:instrumentals · 16:12

    听起来像零散钟声在寂静空间里缓慢荡开,泛音清亮却不喧闹,留白让每一次回响都变得很近。Adrianne Lenker把民谣的私密感揉进即兴器乐的松弛里,整段16分钟像一场持续展开的回声。

    🔗 Spotify · #推歌 #民谣

  8. 📚 「を踏まえて」不是万能“基于”:它和「に基づいて」差在哪?技术报告里很常见一种误用:明明想表达“看了前面的结果之后,做了判断和调整”,却一律写成「〜に基づいて」

    📚 「を踏まえて」不是万能“基于”:它和「に基づいて」差在哪?

    技术报告里很常见一种误用:明明想表达“看了前面的结果之后,做了判断和调整”,却一律写成「〜に基づいて」。其实这时更自然的往往是「〜を踏まえて」。它特别适合安全审计、实验复盘、论文讨论、需求修订这类场景:先有事实或前提,再据此做判断、改写设计、调整方案。

    边界要抓清。「に基づいて」强调“有明确依据”,后面常接规则、定义、法令、规格、正式数据,语气像“依照……来做”。「を踏まえて」则不是机械照搬,而是“把前提情况考虑进去之后,再往下决定怎么做”,后面常接判断、改善、提案、设计变更。至于「をもとに」,语气更宽,偏“以……为素材/基础加工而成”,没有「を踏まえて」那种“考虑之后作判断”的味道。

    所以,「先行研究に基づいて手法を設計した」更像“设计直接建立在既有理论或文献依据上”;而「先行研究の限界を踏まえて手法を設計した」则是在“看清前人不足之后”做出改进,这两个句子在研究写作里不能随便互换。

    例如可以直接这样套用:
    脅威分析の結果を踏まえて、認証フローにデバイス証明を追加した。
    基于威胁分析结果并结合其含义,我们在认证流程中加入了设备证明。

    先行研究の限界を踏まえて、本研究では評価指標にロバスト性を加えた。
    鉴于先行研究的局限,本研究在评价指标中加入了鲁棒性。

    ベンチマークの測定誤差を踏まえて、結果には95%信頼区間を併記した。
    考虑到基准测试的测量误差,结果部分同时标注了 95% 置信区间。

    反过来,如果你要写的是「仕様書に基づいて実装する」「法令に基づいてデータを管理する」,这里就别换成「を踏まえて」,因为重点不是“综合考虑后调整”,而是“按明确依据执行”。

    💡 記憶ポイント:。如果你脑子里想的是“考虑到……之后,我们决定……”,大概率就是「を踏まえて」。

  9. 🔐 哈希长度扩展:拼接式签名为什么一文不值很多系统做消息完整性校验时,图省事会这么干:把密钥和消息直接拼起来,再算个哈希当签名

    🔐 哈希长度扩展:拼接式签名为什么一文不值

    很多系统做消息完整性校验时,图省事会这么干:把密钥和消息直接拼起来,再算个哈希当签名。比如 sig = SHA-256(secret + message),服务器收到请求后自己重算一遍比对,一致就认定是可信来源发的。乍看没毛病,secret 藏在里面,攻击者不知道密钥就算不出合法签名。问题出在哈希算法自身的结构上。

    SHA-256 这类 Merkle-Damgård 系哈希是分块处理的:消息被切成 64 字节的块逐块喂入,每块的输出作为内部状态继续参与下一块计算。于是出现一个致命特性:知道某个消息的哈希值,就等于拿到了处理完该消息后的内部状态。拿到状态就能假装"我已经算到这儿了",继续往后面追加任意内容并算出新哈希,全程不需要知道 secret。唯一要猜的是 secret 的长度,因为它决定中间那段填充怎么写,而枚举几十种长度对工具来说毫无压力。这就是哈希长度扩展攻击(Hash Length Extension)。

    现实中最出名的受害者是 2009 年的 Flickr API:签名方案就是 md5(secret + 参数),攻击者用一个合法请求的签名就能伪造出带额外参数的请求签名。今天仍能看到不少自研 Webhook 签名、游戏防作弊校验在用这种拼串哈希,几乎一测一个准。

    为什么 HMAC 不怕?HMAC 不是简单拼接,它把密钥派生出两个掩码,一个垫在消息前面算内层哈希,一个垫在结果前面算外层哈希,密钥被两层结构封住,长度扩展无从下手。防御口径很朴素:完整性校验一律用 HMAC,或者干脆用 SHA-3 这类海绵结构哈希;永远不要自己发明 hash(secret + message) 的变体。正经平台的 Webhook 签名(比如 Stripe)用的就是 HMAC-SHA256,不是没有原因的。

    🧪 场景分析:某订单接口用 sign = sha256(secret + "user=alice&price=100") 做签名,你截获了一个合法请求,参数和 sign 都可见。能否在不知道 secret 的情况下,伪造出追加 &discount=90(打一折)的请求并算出合法签名?

    m) 就能从内部状态继续追加。用 hashpump 这类工具,枚举猜出 secret 长度后,算出 H(secret补齐填充

    💡 核心记忆:hash(secret + message) 会把哈希内部状态整个交出去,消息完整性校验请认准 HMAC。