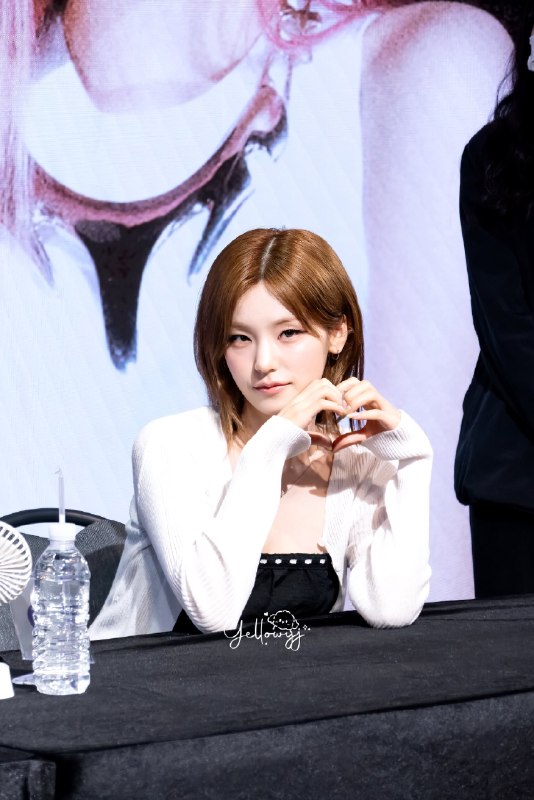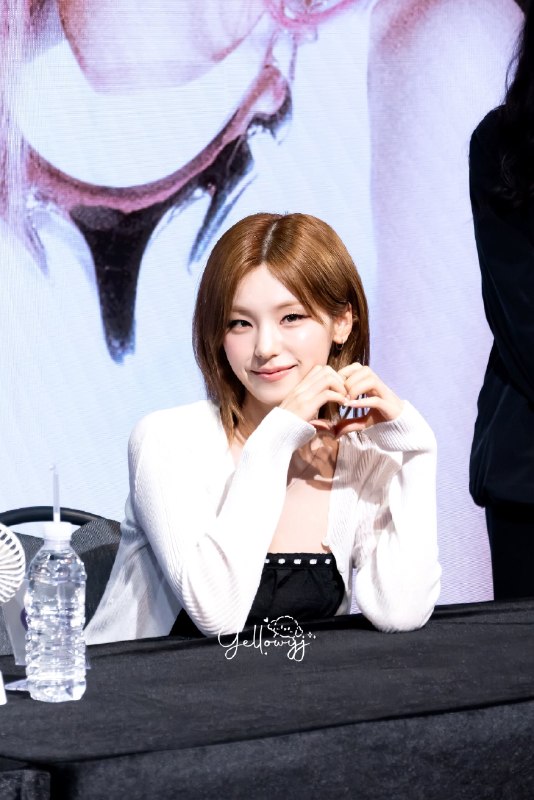Orien Daily

📸 @storingyeji
260727 roger vivier
Across the Autumn 2026 campaign, Global Brand Ambassador YEJI appears in dynamic and spontaneous scenes that balance sophistication with irreverence. She wears the Viv’ Ranger loafers, defined by a low squared heel and a miniature Efflorescence crystal buckle.
https://www.in... #예지 #YEJI
原文 #黄礼志


📚 「〜にあたって」不是万能正式语:它和「〜際して」到底差在哪
很多人一写正式日语,就把「在……时」全都写成「〜にあたって」。结果邮件、研究计划、技术文档里看着挺“高级”,其实边界错了。先说结论:「〜にあたって」强调“面对某个重要节点,带着准备、判断或态度进入下一步”,常见于研究开始、制度实施、系统迁移、申请提交这种带转折感的场景。它不是普通的“之前”或“时候”。
它最容易和「〜際して」混。两者都正式,但「〜際して」更像“值此……之际”,重点是某个时点或机会本身,常见于通知、致辞、公告、手续说明,语气更客观、更书面。「〜にあたって」则更像“在着手这件事时,需要特别处理/说明什么”,后面常接方针、注意事项、准备动作。至于「〜前に」,就别混了,它只是时间先后,正式感和“关键节点”都弱很多。
还有一个不能乱用的地方:「〜にあたって」不适合接很日常、很轻的小动作。像「昼ご飯を食べるにあたって」「メールを見るにあたって」这种就很别扭,因为事件分量不够,也没有“进入某个重要阶段”的感觉。
例句直接拿去用:
本研究を開始するにあたって、先行研究の整理と評価指標の明確化を先に行った。
在开展本研究时,我们先完成了既有研究的梳理,并明确了评价指标。
システム移行に際して、一時的なサービス停止が発生する可能性があります。
值此系统迁移之际,可能会发生临时性服务中断。
機密データを共有するにあたって、アクセス権限と保存先の管理体制を確認する必要がある。
在共享机密数据时,有必要确认访问权限和存储位置的管理机制。
如果你写的是“通知大家某事发生”,优先想「〜に際して」;如果你写的是“开始做一件重要的事,需要先处理什么”,优先想「〜にあたって」;如果只是普通顺序,就老老实实用「〜前に」。
💡 記憶ポイント:
🔐 SSRF 为什么总能绕过“只允许内网访问”的想象
很多人第一次见到 SSRF(Server-Side Request Forgery,服务端请求伪造)时,会把它理解成“攻击者让服务器替自己发一个请求”。这句话没错,但还不够危险。真正麻烦的地方在于,服务器所在的位置、网络权限、身份凭证,往往和外部用户完全不是一个级别。你在浏览器里访问不到的地址,应用服务器却可能轻松访问;你拿不到的云平台元数据接口,后端代码却默认能连。于是一个看起来只是“帮我抓一下图片 URL”或者“帮我读取远程 webhook 内容”的功能,突然就变成了进入内网的跳板。
它为什么会发生?根子通常不是“黑客太厉害”,而是产品和工程习惯出了问题。开发者喜欢写一些通用抓取能力,比如导入头像、预览链接、拉取回调、抓取 PDF、解析 Open Graph 信息。这些功能本质上都在做一件事:让服务器主动请求一个由用户提供的地址。如果这里没有严格限制目标协议、目标主机、跳转行为和解析结果,那用户给的就不再是“一个普通 URL”,而是一条让服务器替他探路的命令。最典型的情况是,开发者只在字符串层面做检查,比如“只要不是 127.0.0.1 就行”,结果攻击者换成 0.0.0.0、localhost 的变体、IPv6 写法、带 DNS 解析的域名,甚至先请求一个外部域名再 302 跳转到内网地址,过滤就成了摆设。
现实里最值钱的 SSRF 目标,不是首页,不是某个后台页面,而是云环境里的 metadata service。比如在 AWS 里,历史上很多 SSRF 攻击最后拿到的不是“一个页面内容”,而是实例角色的临时凭证。拿到这个东西,问题就从“读了一下内网接口”升级成“可以调用云 API 了”。这也是为什么现在很多云厂商都在推动更严格的元数据访问机制,比如 AWS IMDSv2 要求先拿 token,再访问元数据;它的目的不是让流程更麻烦,而是让那种“随手一发 HTTP 请求就能读凭证”的情况直接失效。
防 SSRF 不能靠一句“我们加个黑名单”。黑名单是补丁思维,迟早漏。更靠谱的做法是把“服务器能替用户访问什么”收窄成一个很小的白名单问题。比如这个功能如果只是抓头像,那就只允许 https,且只允许访问少数明确的公共域名;如果是 webhook 回调,就让它只打到预先登记过的目的地;如果业务上根本不需要服务器主动访问外部 URL,那就别做这个能力。再往下一层,网络出口也该有限制,应用容器不该随便访问内网管理面、云元数据地址、本机 loopback。代码层检查和网络层隔离都要有,缺一个都容易翻车。
🧪 你在审一个“网页截图”功能:用户提交任意 URL,后端用无头浏览器打开后返回截图。开发者说“没事,我们已经禁止了127.0.0.1和localhost,所以内网是安全的”。这句话最大的问题是什么?127.0.0.1localhost
💡 核心记忆:SSRF 的本质不是“请求长得可疑”,而是“你让服务器替用户决定它该连谁”。
🔑 为什么 epoll 的边缘触发更快,却更容易把程序写挂
很多人第一次学 Linux I/O 多路复用时,会把epoll的边缘触发(ET, Edge Triggered)理解成“高级版通知”,水平触发(LT, Level Triggered)理解成“普通版通知”。这说法太糙了,真正的区别在于:内核到底是在“数据还没处理完”时反复提醒你,还是只在“状态发生变化”的那一刻提醒你一次。
先看水平触发。假设一个 socket 里已经有 4KB 数据没读走,只要这 4KB 还在,下一次epoll_wait仍然会告诉你“这个 fd 可读”。这种设计很啰嗦,但非常稳,因为你哪怕一次只读一点,甚至代码写得有点笨,内核也会不断催你把活干完。它像一个不会闭嘴的闹钟,代价是通知次数更多。
边缘触发反过来。它关心的不是“现在还有没有数据”,而是“从没有数据变成有数据”这个边缘。一旦 socket 从空变成非空,内核通知你一次;如果你这次没把缓冲区读空,剩下的数据还在,但因为“状态没有再次变化”,下一次未必还会提醒你。设计它的原因很直接:减少重复通知,减少用户态和内核态来回切换,让高并发服务器更省开销。
问题也正出在这里。很多 ET 程序挂掉,不是因为epoll有问题,而是因为程序员把它当 LT 在写。最典型的坑有两个。第一个坑是“收到可读事件后只读一次”。这在 LT 下通常还能凑合,在 ET 下就可能直接丢掉后续处理机会,因为内核已经提醒过你了。正确做法是把 fd 设成 non-blocking,然后在一次事件处理中循环read,一直读到返回EAGAIN或EWOULDBLOCK,意思是“现在真没了”。第二个坑是“收到可写事件后一直盯着写”。socket 可写往往是常态,如果你没设计好发送缓冲和事件注册策略,就会被大量无意义的可写事件拖死,CPU 空转得很难看。
所以 ET 更快,不是因为它神秘,而是因为它假设你更自律:你得一次把该做的事做干净。LT 则更像宽容模式,允许你每次只处理一部分,然后等内核继续提醒。写网络服务器时,如果你对事件循环、非阻塞 I/O、读写缓冲管理还不够扎实,先用 LT 往往更稳;如果你已经能保证“来一次事件就把状态推进到不能再推进为止”,ET 才值得上。
🧪 如果一个 socket 使用 epoll 的 ET 模式,并且已经收到一次“可读”通知,但你的程序只读了部分数据就返回事件循环,之后这个 socket 里剩余数据还没被读完,那么下一次epoll_wait一定还会再次返回这个可读事件吗?EAGAIN
💡 易混淆点:ET 不是“每来一个数据包通知一次”,LT 也不是“性能一定差”,真正边界在于你是否把一次事件处理到EAGAIN为止。
每日推歌已发送
📸 @CFADnFpiqAnFf0T ×2
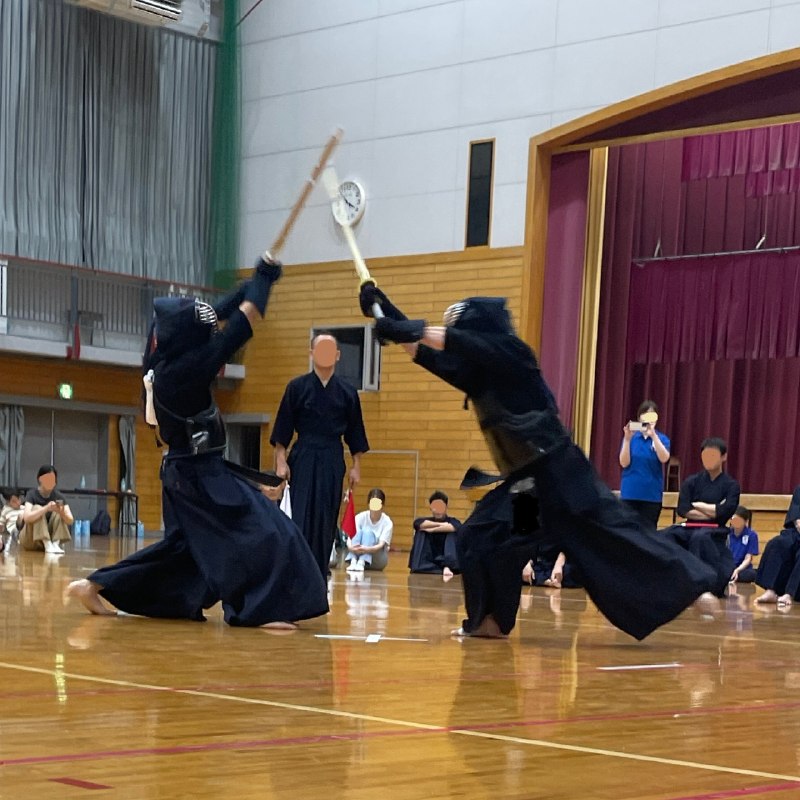
近隣の道場からの参加者を募ってのローカルな大会の審判員を務めました。ローカルな大会と言ってもリーグ戦から勝ち上がっての決勝トーナメント戦では、参加選手の実力はそれ相当のレベルの試合内容でした。昨年も審判員を務めさせて頂きましたが、緊張の連続でした。 #剣道
原文 #剣道