Orien Daily

⚠️ Cron job '日本語知識點' failed:
RuntimeError: Error code: 403 - {'error': {'message': 'openai_error', 'type': 'bad_response_status_code', 'param': '', 'code': 'bad_response_status_code'}}
当服务器替你发请求:SSRF 如何把内网暴露给攻击者
你访问了一个网站,网站帮你去取一张图片——这听起来再正常不过了。但问题就出在这个"帮你去取"上。如果服务器在拿到你给的 URL 之后,不验证、不过滤,直接去请求,那它就不只是在帮你取图片,它在帮你取整个内网。
这就是 SSRF,Server-Side Request Forgery。攻击者精心构造一个 URL,让服务器去访问它本来不该访问的内网资源——云环境的元数据接口、内部服务的 API、数据库的管理端口。服务器有权限访问这些东西,而攻击者没有,但攻击者借服务器的手去碰了它们。2019 年 Capital One 数据泄露,超过一亿条客户记录被盗,入口就是一个 SSRF 漏洞,攻击者通过它拿到了云实例的 IAM 凭证。
SSRF 的杀伤力跟部署环境直接相关。传统机房里,它可能只泄露内网信息。但到了云环境就不一样了——AWS、GCP、Azure 都在169.254.169.254暴露实例元数据,一旦 SSRF 触达这个地址,临时凭证、角色权限全出来了,直接接管云资源。所以云时代 SSRF 的危害被放大了不止一个量级。
防御的思路其实很直:服务器不该请求的地方,就不让它请求。最有效的措施是维护一个允许的目标白名单,非白名单内的请求直接拒绝。如果白名单不好维护,至少做到禁止请求私有 IP 段和云元数据地址。另外,在出口方向部署防火墙策略,限制服务器出站能访问的端口和协议,也能大幅缩小爆破面。如果你用云服务,很多提供商已经支持 IMDSv2,要求请求必须带一个一次性 token 才能访问元数据——这就把 SSRF 获取凭证这条路基本堵死了。
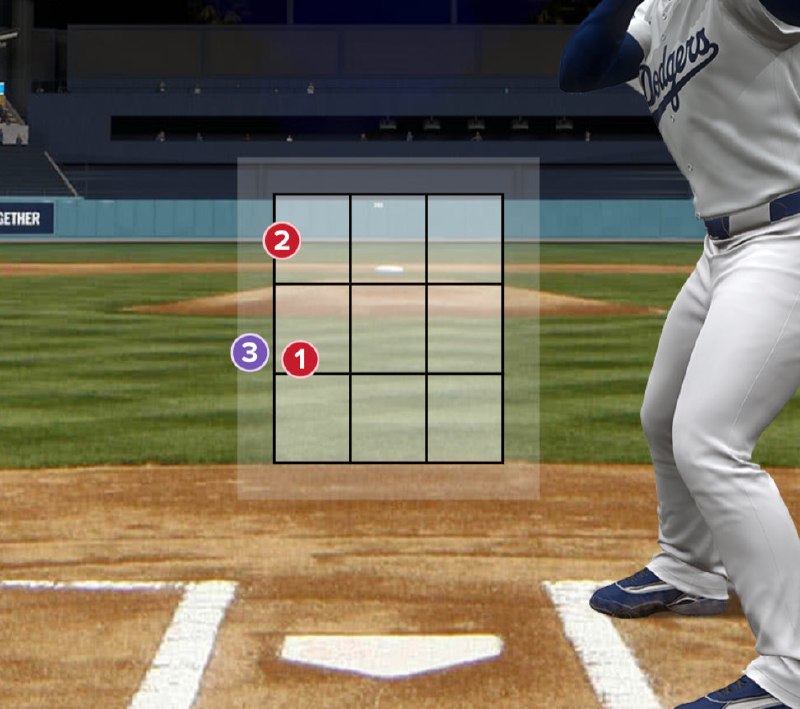
📸 @30R9gmaMUy3guDJ大谷翔平選手の第1打席はライトフライ外野に運ぶも、バットの先であとひと伸び足りず👀ニック・マルティネスと対戦!①右飛 #大谷翔平 #ドジャース原文 #MLB日本選手
📸 @30R9gmaMUy3guDJ
大谷翔平選手の
第1打席はライトフライ
外野に運ぶも、バットの先であとひと伸び足りず👀
ニック・マルティネスと対戦!
①右飛 #大谷翔平 #ドジャース
原文 #MLB日本選手
📸 @PlumLapis
一昨日 日曜日 市民大会個人戦
10年ぶり?くらいでしょうか
40代以降はグッと出場人数が減る中で
試合に出る選択をするだけ偉いよね?私!
怪我する…あちこち痛くなるとか言い訳だよね?
負けるのが怖いから試合に出たくない人が多いんじゃないかなー?
まだ全身筋肉痛さぁ #Fellows #剣道
原文 #剣道
Linux 内核的 RCU:读不加锁的魔法
读多写少是服务器里最常见的场景。路由表、进程描述符、安全策略——这些数据几乎每纳秒都在被读取,修改却少之又少。经典做法是给读者加读写锁(rwlock),读者拿读锁,写者拿写锁。听起来合理,但问题是:哪怕所有线程都在读、没有任何人在写,读锁本身的开销也不为零。缓存行上的一次 atomic 操作就得几十纳秒,在高频路径上累积起来很可观。
Paul McKenney 在九十年代想了一个看似疯狂的方案:读的时候完全不加锁,连 barrier 都不打。写者修改数据时不是原地覆盖,而是先拷贝一份,改拷贝,再把指针原子地切过去。旧的读者还在看老数据,没关系,让它看完。等所有可能的旧读者都离开了(内核已经有办法检测这一点),再回收老副本。这就是 RCU——Read-Copy-Update。
它的核心想法其实特别朴素:。这个窗口叫做 grace period,在非抢占内核里就是一个完整的调度周期——只要每个 CPU 都经历过一次上下文切换,就说明没有旧读者还卡在临界区里了。synchronize_rcu()就是等这个周期,call_rcu()是异步版本,注册一个回调在 grace period 结束后自动释放旧数据。
代码写起来非常简单。读者侧就是rcu_read_lock()/rcu_read_unlock(),在非抢占配置下编译成空操作——零指令。写者侧用rcu_assign_pointer()发布新指针,用kfree_rcu()延迟释放旧结构。整个 API 面极窄,心智负担几乎没有。
不过 RCU 不是银弹。 而且synchronize_rcu()本身的等待开销很大,写者多的场景反而不如 rwlock。
2010 年以后 Linux 内核里 RCU 的使用量爆炸式增长,网络子系统、VFS、cgroup、sched 几乎全部迁移到了 RCU。原因很简单:在多核机器上,读路径每省一条指令都是几十万 QPS 的差距。